AIクローラーとは?種類一覧とrobots.txtでの制御方法を解説
INDEX
「AIクローラーはブロックすべきでしょうか、それとも許可すべきでしょうか」──最近よくいただく質問ですが、実はこの二項対立の問いの立て方自体に、落とし穴があります。AIクローラーには目的の異なる3つの種類があり、それを区別せずに判断すると、「ChatGPTに自社を引用してほしいのに、その検索用クローラーまで止めてしまう」「学習利用だけ避けたいのに、すべて素通しにしてしまう」という逆転事故が起きるからです。本記事では、AIクローラーの3分類という判断の枠組みを示したうえで、日本の企業サイトにとって重要度の高いChatGPT・Gemini・Claudeを中心とする主要クローラーの一覧、robots.txtの記述例(コピペ可)、許可・拒否の判断基準、アクセスログでの確認方法まで、実務を一気に解説します。なお、生成AI最適化(LLMO)の全体像で言えば、AIクローラーの制御は6層構造図の第2層「アクセス制御」にあたります。llms.txtが「ここを読んでほしい」と伝える案内係だとすれば、本記事で扱うのは「入ってよいかどうか」を決める門番の役割を担います。
- 1.
AIクローラーとは ― 生成AIの「情報収集係」
AIクローラーとは、生成AIサービスがモデルの学習や回答の生成のために、Web上の情報を自動で収集するプログラムの総称です。従来からある検索エンジンのクローラー(Googlebotなど)と技術的な仕組みは似ていますが、目的が異なります。検索クローラーはページを収集してインデックス(索引)を作り、その見返りとして検索結果からの訪問者をサイトに送り返します。一方、AIクローラーが収集した情報は、AIモデルの学習素材になったり、AIの回答文の材料になったりします。回答の中で引用として紹介されることはあっても、従来の検索結果ほど太い自社サイトへの流入は期待できません。この「クロールと見返りの非対称」が、いまWeb業界でAIクローラーが議論を呼んでいる背景です。
だからといって、「AIクローラー=一律に締め出すべき悪者」でも「AI時代の集客装置だから全部歓迎」でもありません。本記事では多くの日本の企業のみなさまに参考になるように、できるだけ客観的に事象を捉え、考え方を含めて、対策を解説していきます。AIクローラーは、目的別に付き合い方を決める対象である。そのためにまず必要なのが、次章の3分類の理解です。
- 2.
AIクローラーの3分類 ― 判断を誤らないための枠組み
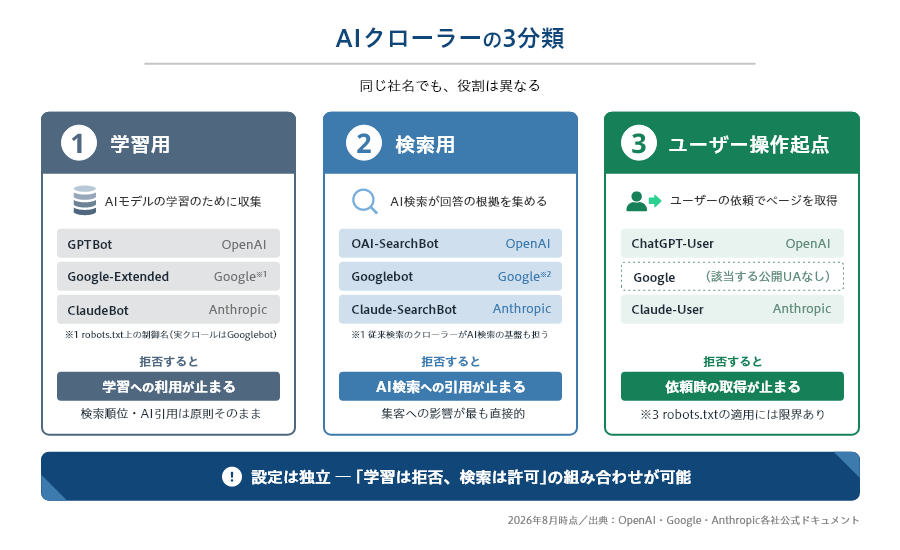
主要なAI事業者は、目的の異なる複数のクローラーを使い分けています。その役割は大きく3つに分かれます。
(1)学習用:AIの基盤モデルの学習・改善のためにWebコンテンツを収集するクローラーです。代表例は、GPTBot(OpenAI)、ClaudeBot(Anthropic)、そしてGoogleのGoogle-Extended(正確には後述のとおり制御用の指定名です)。重要なのは、これらを拒否しても、Google検索の順位やAI検索での引用には原則として影響しないことです。学習への提供可否だけを決める入り口だからです。(※1)(※2)(※3)
(2)検索用:AI検索が回答の根拠となるページを見つけ、索引化するためのクローラーです。代表例は、OAI-SearchBot(ChatGPTの検索機能)とClaude-SearchBot(Claudeの検索機能)。こちらは逆で、拒否するとそのAI検索の回答で自社が引用・表示されなくなります。OpenAIは「OAI-SearchBotを拒否したサイトはChatGPTの検索回答に表示されない」と公式に明言しています。(※1)(※2)
(3)ユーザー操作起点:ユーザーがAIに「このURLを読んで要約して」と依頼したときなど、人の操作をきっかけにページを取得するアクセスです。代表例は、ChatGPT-UserとClaude-User。自動巡回するクローラーというより、「ユーザーの代理で動くブラウザ」に近い存在です。この性質の違いは、後述するrobots.txtの効き方にも関わってきます。(※1)(※2)
ここで重要なポイントは、同じ社名でもクローラーによって役割が違う、ということです。GPTBot(学習用)とOAI-SearchBot(検索用)を同じ扱いにしてはいけません。「AI」という名前がつくものを一括で拒否する設定は、学習を止めると同時にAI検索からの引用機会も消してしまう、最も危険な設定です。各社とも設定は独立しており、「学習は拒否、検索は許可」という組み合わせが可能なように設計されています。(※1)
- 3.
主要AIクローラー一覧 ― ChatGPT・Gemini・Claudeを中心に(2026年8月時点)
ChatGPTのクローラー(OpenAI) ― 3種の使い分け
GeminiとGoogle検索のクローラー ― Google-Extendedの正確な理解
Googleについては、誤解が最も多いポイントを最初に押さえてください。Google-Extendedは、独立したクローラーではなく、robots.txtに書く制御用の指定名(トークン)です。実際のページ収集は従来どおりGooglebotが行い、Google-Extendedへの許可・拒否は「収集済みコンテンツをGeminiの学習やグラウンディング(AIが回答の根拠として検索情報を参照する仕組み)に使ってよいか」だけを制御します。したがって、Google-Extendedを拒否しても、Google検索の順位やインデックスには影響しません。逆に、Googlebot自体を拒否すれば検索から消えます。この2つは別物です。(※3)
なお、Google検索のAI Overviews(AIによる概要)に自社が表示されるかどうかの制御は、Google-Extendedではなくnosnippet等の別の仕組みで行います。詳しくは別記事「AI Overviewsとは」で解説しています。GeminiはGoogle検索やWorkspaceとの連動で接点が広いサービスです。集客を狙う企業サイトの基本は、Googlebotは当然許可、Google-Extendedは学習方針次第、と整理できます。
Claudeのクローラー(Anthropic) ― 3種すべてがrobots.txtを遵守
Anthropicも同じ3層構造で、ClaudeBot(学習用)、Claude-SearchBot(検索用)、Claude-User(ユーザー操作起点)の3種を公式ヘルプで公開しています。特筆すべきは、Anthropicがユーザー操作起点のClaude-Userを含む3種すべてについてrobots.txtの遵守を明記していることです(この点は各社で立場が分かれており、次章で扱います)。Claudeはビジネス・開発用途で利用が広がっているサービスです。Claudeの回答で引用されたいなら、Claude-SearchBotとClaude-Userの許可が基本です。(※2)
以上を含む主要AIクローラーを一覧にまとめます。
提供元 | User-Agent/指定名 | 分類 | 拒否した場合の影響 |
|---|---|---|---|
OpenAI | GPTBot | 学習用 | 将来のモデル学習への利用を拒否 検索・引用には原則影響なし |
OpenAI | OAI-SearchBot | 検索用 | ChatGPTの検索回答に表示されなくなる |
OpenAI | ChatGPT-User | ユーザー操作起点 | ユーザー依頼時のページ取得を拒否(適用に限界あり・本文参照) |
Googlebot | 検索用(従来検索) | Google検索から消える(AIクローラーではないが基準点として記載) | |
Google-Extended | 学習用(制御トークン) | Geminiの学習・グラウンディングへの利用を拒否、検索順位に影響なし | |
GoogleOther | 汎用(研究開発等) | Googleの各種製品・研究用途の取得を拒否 | |
Anthropic | ClaudeBot | 学習用 | 将来のモデル学習への利用を拒否 |
Anthropic | Claude-SearchBot | 検索用 | Claudeの検索結果での表示・引用機会が減る |
Anthropic | Claude-User | ユーザー操作起点 | ユーザー依頼時のページ取得を拒否(Anthropicは遵守を明記) |
Perplexity | PerplexityBot | 検索用 | Perplexityの回答で引用されなくなる |
Perplexity | Perplexity-User | ユーザー操作起点 | 原則robots.txtの対象外と公式明記(本文参照) |
Common Crawl | CCBot | 学習用 | 公開データセット(多くのAI学習に利用)への収録を拒否 |
ByteDance | Bytespider | 学習用 | 同社AIの学習用収集を拒否 |
Apple | Applebot-Extended | 学習用(制御トークン) | Appleの生成AIの学習への利用を拒否 |
Meta | Meta-ExternalAgent | 学習用ほか | 同社AIの学習等の収集を拒否 |
※User Agent名・仕様は各社の判断で変更されうるため、設定時は必ず各社公式ドキュメント(※1〜※4)を確認してください。本表は2026年8月時点の情報です。
- 4.
何もしないと、どうなるか ― 「未設定」は中立ではない
ここまで読んで、「うちのサイトは何も設定していないが、大丈夫だろうか」と思われた方も多いはずです。答えを先に言えば、「何もしない」は中立な状態ではありません。robots.txtの仕組み上、記述のないクローラーへの扱いは「すべて許可」です(※4)。AIクローラーについて何も書いていないサイトは、意図したかどうかにかかわらず、学習用・検索用・ユーザー操作起点のすべてを許可している状態にあります。公開しているコンテンツは、すでにAIの学習にも回答の生成にも使われうる、ということです。
一方で、逆向きに倒れているサイトもあります。CDN(コンテンツ・デリバリー・ネットワーク)大手のCloudflareが2025年7月から新規登録ドメインでAIクローラーを既定でブロックする方針に転換したため(詳細は次章)、Cloudflare等を利用しているサイトでは、何も設定した覚えがないままAIクローラーが全拒否になっているケースがあります。セキュリティ製品やWAFが疑わしいアクセスとして自動的に弾いている場合もあります。つまり「何もしていない」サイトの実態は、「全許可」か「意図せぬ全拒否」のどちらかに倒れています。
厄介なのは、どちらに倒れていても日常業務では気づけないことです。全拒否側に倒れていた場合、AI検索で引用される機会を失い続けますが、AIクローラーの訪問はGA4などのアクセス解析に現れないため(理由は後述)、この機会損失は数字に表れません。全許可側であっても、それが意図した選択でなければ、学習利用について自社の方針を持たないまま既成事実だけが積み上がっていきます。
「何もしない」とは、「決めていない」のではなく、「知らないうちに決まっている」状態です。だからこそ、①まず現状を確認し(確認方法は後述の章で解説します)、②自社の方針を決め(判断基準も後述します)、③robots.txtに意思を書く、この順で一度だけ棚卸しをすることをおすすめします。作業自体は半日もかかりません。次章から、その具体的な手順に入ります。
- 5.
制御の実務 ― robots.txtの書き方と、その限界
制御の基本はrobots.txtです。サイトのルート直下(https://あなたのドメイン/robots.txt)に置いたテキストファイルに、クローラー名(User-agent)と許可・拒否(Allow/Disallow)を書くだけで、対応するクローラーに意思を伝えられます。方針別に、コピペで使える記述例を3パターン示します。
パターン①:原則すべて許可(集客重視・当社の方針)─AI経由の認知・引用を集客機会と捉えるサイト向け。管理系URLだけを全クローラー共通で拒否します。なお、robots.txtの仕様では「記述のないURLは許可」がデフォルトのため、Allow: / は書かなくても挙動は同じです。それでも当社が明示をおすすめするのは、このファイルが「拒否のための設定」ではなく「意思を持って許可している」ことを、後からファイルを見る人(将来の担当者・監査・そしてAI事業者)に誤解なく伝えられるからです。仕様上も、同一グループ内ではパスの長い規則が優先されるため、Allow: / と Disallow: /admin/ は正しく両立します(管理系だけが拒否され、他はすべて明示的に許可)。(※4)
# パターン① 原則許可(全体をAllowで明示・管理系のみ拒否) User-agent: * Allow: / Disallow: /admin/ Disallow: /wp-admin/ Sitemap: https://example.com/sitemap.xml |
1つだけ、書き方の落とし穴に注意してください。クローラーは、robots.txtの中で自分の名前に最も一致する1つのグループだけに従い、他のグループは無視します。したがって、「User-agent: GPTBot + Allow: / 」のようにクローラー名を挙げた許可専用グループを別に作ると、そのクローラーにはUser-agent: * 側の規則(管理系URLの拒否など)が適用されなくなります。全体の方針をUser-agent: * のグループ1つにまとめるのが、パターン①の安全な書き方です。逆に、次のパターン②のようにクローラー名ごとのグループを作る場合、管理系URLの拒否も必要なら各グループに複製する必要があります。(※4)
パターン②:学習用のみ拒否・検索用とユーザー起点は許可(分離運用)─コンテンツの学習利用は避けたいが、AI検索での引用は確保したいサイト向け。
# パターン② 学習用のみ拒否 User-agent: GPTBot Disallow: / User-agent: Google-Extended Disallow: / User-agent: ClaudeBot Disallow: / User-agent: CCBot Disallow: / User-agent: Bytespider Disallow: /
# 検索用・ユーザー操作起点は許可(明示) User-agent: OAI-SearchBot Allow: / User-agent: ChatGPT-User Allow: / User-agent: Claude-SearchBot Allow: / User-agent: Claude-User Allow: / Sitemap: https://example.com/sitemap.xml |
パターン③:AIクローラーを全拒否(有料コンテンツ等)─コンテンツ自体が商品であるサイト向け。上記の学習用・検索用・ユーザー起点のUAをすべてDisallow: /で列挙します(Googlebotまで拒否しないよう注意してください。検索から消えます)。
当社unisrv.jpは、学習用を含むパターン①(原則すべて許可)の立場です。エネルギー業界向けSaaSとAI Ready Webという当社の事業にとって、AIに正しく読まれ、引用されることは認知獲得の機会だからです(実物: https://unisrv.jp/robots.txt)。正直に言えば、学習用まで許可するかは、当社でも最後まで迷った論点です。学習データに取り込まれた知見は、出典の表記なくAIの「一般知識」として再生成されうる、つまり自社の知見が一般論のように扱われることは、知財の観点からは望ましくないからです。それでも当社が全許可を選んだ理由は2つあります。第一に、検索用とユーザー操作起点を許可して知見の参照・要約を認める以上、学習用だけを拒否しても公開した知見の流通は実質的に止められず、保護の効果が限定的であること。第二に、AIモデルの知識として取り込まれることは、中長期的には自社の考え方が「その分野の標準」としてAIの回答に反映されていく可能性がある、まさにThought Leaderとしてのポジションを確立する機会でもあること。当社は自らを実験台として、この立場の成果を検証し、発信していきます。もっとも、これは唯一の正解ではなく、事業とコンテンツの性質を踏まえた経営判断です。知見や情報そのものが商品である企業なら、逆の結論(次章の分離運用)が合理的になります。そして、この判断をリードすることは、マーケティング責任者・Web責任者の新しい大きな仕事だと当社は考えています。
robots.txtの限界 ― 紳士協定であるという現実
またここで、誠実にお伝えすべき事実があります。robots.txtに強制力はありません。Google自身が公式ドキュメントで「robots.txtファイルの指示はクローラーの動作を強制できない。従うかどうかはクローラー次第である」と明言しているとおり、robots.txtは業界の慣行として尊重されてきた紳士協定でしかありません。(※4)
実際、適用範囲には各社で立場の違いがあります。ユーザー操作起点のアクセスについて、OpenAIは「ユーザーが開始した操作のため、robots.txtのルールが適用されない場合がある」と明記し、Perplexityも「Perplexity-Userは原則としてrobots.txtを無視する」と公式ドキュメントに記しています。一方Anthropicは、前述のとおり3種すべての遵守を明記しています。というように、「人間の代理として動くアクセスは、ロボット向けの規約の対象なのか」という論点に、業界の答えはまだ揃っていないのです。(※1)(※2)(※5)
遵守をめぐる事件も起きています。2025年8月、Cloudflareは、robots.txtとファイアウォールの両方でブロックされているサイトに対し、Perplexityが申告外のユーザーエージェント(一般的なブラウザを装った識別名)でアクセスしていたとする検証結果を公表し、同社を認証済みボットのリストから除外しました。なお同じ検証で、OpenAIのクローラーはrobots.txtの拒否指定に従って取得を停止したことも確認されています。これに対しPerplexity社は指摘に反論しており、ユーザーの指示を受けて動くAIエージェントのアクセスを、従来の自動クローラーと同一視すべきではない、という立場を示しています。個社の評価はさておき、この事例が示すのは一つの事実です─robots.txtだけでは、守りたいものは守れない。(※6)
技術的に確実に遮断したい場合は、CDN(コンテンツ・デリバリー・ネットワーク)やWAF(Webアプリケーションファイアウォール)のボット対策を併用します。この分野で市場を大きく動かしたのがCloudflareで、2025年7月から新規登録ドメインではAIクローラーを既定でブロックする方針に転換しました。同社はWeb全体の約2割を担うため、影響は甚大です。あわせて、クロールに対価を求める仕組み(Pay Per Crawl、2026年にはコンテンツの利用実績に応じて支払うPay Per Useへ発展)も開始しており、「AIによるクロールはタダではない」という市場が形成されつつあります。(※5)
そして、集客したい側にとっての逆方向の注意点がここから生まれます。貴社サイトがCloudflare等のCDNを利用している場合、意図しないままChatGPT・Gemini・Claudeのクローラーをすべてブロックしている可能性があります。robots.txtで許可していても、その手前のCDNが遮断していれば意味がありません。AI検索からの集客を狙うなら、robots.txtとあわせてCDN・WAFのボット設定を必ず確認してください。これは、AIクローラー対応の実務で最も見落とされているチェックポイントです。
- 6.
許可・拒否の判断基準 ― サイトタイプ別
では、自社はどう設定すべきか。判断は次の3問で整理できます。
①コンテンツ自体が商品か(有料記事・会員限定・データベースなど、読まれること=売上の毀損になるか)。
②AI経由の認知・引用が集客に効くか(顧客の情報収集にAIが使われる業種か)。
③サーバー負荷は問題になる規模か。
サイトタイプ | 推奨方針 | 理由 |
集客目的のB2B企業サイト | 原則すべて許可(パターン①) | AI経由の認知・引用は失うものより得るものが大きい。当社もこの立場 |
有料メディア・DB型サイト | 学習用のみ拒否(パターン②) | 商品価値の保全と、AI検索での発見可能性を両立できる |
EC・その他 | 中間(目的から逆算) | 商品情報はAI引用が販促になる一方、独自コンテンツの扱いは方針判断 |
確認の優先順位も実務的に決められます。まず、自社の顧客が使うAIサービスから逆算することです。日本のB2B読者であれば、ChatGPT系(OAI-SearchBot・ChatGPT-User)→Gemini系(Googlebot・Google-Extendedの設定整合)→Claude系(Claude-SearchBot・Claude-User)のUAの許可状態から順に確認していけば、影響の大きい順に押さえられます。
最後に、他記事を通じて当社がお伝えしている優先順位を、ここでも繰り返します。門番の設定より先に、案内した先の中身です。AIクローラーを通しても、通った先のページをAIが読み取れなければ引用は生まれません。情報の構造化と構造化データという土台づくりが重要であり、クローラー制御は第2層の入り口管理です(全体の優先順位はLLMOの記事をご覧ください)。
- 7.
確認方法 ― 自社サイトに来ているAIクローラーを観測する
- 8.
まとめ ― 二項対立ではなく、3分類で決める
本記事の要点を整理します。AIクローラーは「全部ブロックか、全部許可か」で判断するものではありません。学習用・検索用・ユーザー操作起点の3分類を理解し、同じ社名でも役割が違うことを踏まえて、自社の事業目的から逆算して設定する。これがAIクローラー制御に関する現時点での正解です。robots.txtは第一の手段ですが強制力のない紳士協定であり、確実な遮断はCDN・WAFの分野です。逆に集客側は、CDNが意図せずAIクローラーを締め出していないかの確認を忘れないでください。そして繰り返しになりますが、クローラー制御は6層構造の第2層にすぎません。本丸は、通した先でAIが読める・理解できる情報の土台です。優先順位を見失わなければ、robots.txtの設定は数十分で終わる、確実に機能する施策です。
- 9.
よくある質問(FAQ)
Q1. AIクローラーとは何ですか?
Q2. AIクローラーをブロックするとSEOに影響しますか?
Q3. robots.txtに書けば必ず止まりますか?
Q4. ChatGPTに引用されたい場合、どのクローラーを許可すべきですか?
Q5. 結局、許可すべきですか、拒否すべきですか?
- 10.
注釈・出典
※1 OpenAI「Overview of OpenAI Crawlers」:GPTBot(学習用)・OAI-SearchBot(検索用)・ChatGPT-User(ユーザー操作起点)の3種と独立制御、OAI-SearchBot拒否時は検索回答に非表示、ChatGPT-Userは「ユーザーが開始した操作のためrobots.txtルールが適用されない場合がある」旨、各UAのIPアドレスリスト(JSON)を記載。 https://developers.openai.com/api/docs/bots
※2 Anthropic「Does Anthropic crawl data from the web, and how can site owners block the crawler?」(2026年2月更新):ClaudeBot(学習用)・Claude-SearchBot(検索用)・Claude-User(ユーザー操作起点)の3種、それぞれを拒否した場合の影響、3種すべてのrobots.txt遵守とCrawl-delay対応を記載。 https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
※3 Google クローリング インフラストラクチャ「Google の共通クローラー」(Google-Extendedの項):Google-Extendedは独立したクローラーではなくrobots.txt上の制御用トークンであり(クロール自体は既存のGoogle UAが実施)、「Gemini アプリとVertex AIを支えるGeminiモデルの学習」および「グラウンディング(回答時にGoogle検索インデックスの内容をモデルに提供する仕組み)」への利用可否を管理すること、Google検索へのサイト掲載に影響せず検索のランキングシグナルにも使用されないことを記載。 https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers?hl=ja
※4 Google 検索セントラル「robots.txt の概要」:「robots.txtファイルの手順によってサイトでのクローラーの動作を強制することはできません。手順に従うかどうかはクローラー次第です」の趣旨を記載(紳士協定性の一次ソース)。 https://developers.google.com/search/docs/crawling-indexing/robots/intro あわせて、優先順位の仕様はGoogle クローリング インフラストラクチャ「Google による robots.txt の指定の解釈」:記述のないURLは許可がデフォルトであること、同一グループ内では最も限定的な(パスの長い)規則が優先され、同長の場合は制限の緩い規則(Allow)が適用されること、クローラーは最も一致するUser-agentグループに従うことを記載。 https://developers.google.com/crawling/docs/robots-txt/robots-txt-spec?hl=ja
※5 Perplexity「Perplexity Crawlers」(公式ドキュメント):PerplexityBot(検索用)とPerplexity-User(ユーザー操作起点)の2種、Perplexity-Userについて原則robots.txtの対象外とする位置づけを記載。 https://docs.perplexity.ai/guides/bots
※6 Cloudflare公式ブログ:①「Content Independence Day: no AI crawl without compensation」(2025年7月1日)=新規ドメインでのAIクローラー既定ブロックとPay Per Crawlの開始。 https://blog.cloudflare.com/content-independence-day-no-ai-crawl-without-compensation/ ②「Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives」(2025年8月4日)=申告外UAでのクロール検証結果と認証済みボットリストからの除外、同テストでOpenAIのクローラーは拒否指定に従い停止したことの確認。 https://blog.cloudflare.com/perplexity-is-using-stealth-undeclared-crawlers-to-evade-website-no-crawl-directives/
※7 総務省「令和7年版 情報通信白書」第Ⅰ部「個人におけるAI利用の現状」:日本の個人の生成AIサービス利用経験が26.7%(2024年度調査。前年度9.1%から約3倍に増加)であることを記載。 https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112210.html
2026年9月14日
この記事の著者
甲斐 博一
ユニファイド・サービス株式会社 CMO
グローバルIT企業における23年間のマーケティング経験に経営企画のスキルも加えB2B/B2Cともに経営とマーケティングを結び付けていくことをモットーとする。また、数多くのデジタルマーケティングおよびECの立ち上げや衰退ビジネスの立て直しも経験し、Webサイトを事業に貢献させてきた経歴を持つ。現在はユニファイド・サービスにて、B2B領域のビジネスにフォーカスし、CMOとしてマーケティングを推進すると同時に、新規事業計画と成長を支援する活動を並行して実践中。経営とマーケティング、事業企画、そしてリーダーシップを次世代に伝えていくための活動もライフワークとして行っている。
Web関連記事

- 最新AIチャットボットの仕組みや技術、導入ポイントを解説

- 【MEO対策ガイド】ローカル検索で上位表示を実現する4つの戦略
- AI SEOとは?AIを活用したSEO対策とLLMO/GEOの全体像を専門家が解説【2026年版】

- オーガニック検索とは?流入が減少する原因と回復のための実践的SEO対策

- コールセンターへのAI導入完全ガイド|種類・活用事例・現場の不安を解消する段階的アプローチ
- 構造化データとは?SEO効果・JSON-LD実装方法・AI検索(GEO)対策まで解説【2026年版】

- Googleビジネスプロフィールとは?集客につなげるMEO対策の基本を解説
- AI Webとは?3つの意味と、AIに選ばれるサイトの作り方・情報戦略を徹底解説【2026年版】

- チャットボット導入ガイド|生成AI時代に成果を出すための選び方と運用の秘訣

- Webサイトリニューアル完全ガイド|目的設定から費用・RFP作成・制作会社選定まで徹底解説

- サイト内検索とは?導入効果・選び方からAI×自然文検索の最新動向まで専門家が解説

- 「AI-Readyな企業」に欠けている視点 ―組織・データだけでなく、Webサイトも“AI対応”が必要な理由
- LLMOとは?生成AI時代の最適化(LLMO対策)を実践解説
- AI Overviewsとは?表示の仕組みと引用されるための対策
- llms.txtとは?書き方・設置方法と効果を解説
- AIクローラーとは?種類一覧とrobots.txtでの制御方法を解説